SEO AI dalam Praktik: Cara Mengaudit Visibilitas Brand di ChatGPT, Gemini, dan Perplexity


Oleh Angelica · Diperbarui 11 November 2026
Visibilitas brand di jawaban AI tidak diukur dengan peringkat. Pertanyaannya ada empat: apakah brand Anda disebut, di urutan ke berapa di antara brand lain, dengan nada apa, dan dari sumber mana mesin AI mengambilnya. Itulah inti SEO AI yang bisa diukur, dan Anda tidak perlu membeli tool dulu untuk mulai.
Uji coba kami pada 11 November 2026 menunjukkan batas pengukuran ini: alat ukur mendeteksi elemen AI Overview di setiap balasan yang berhasil, tetapi tidak bisa membaca isinya satu pun. Satu tangkapan layar ChatGPT tidak bisa dijadikan bukti untuk rapat direksi.
Ringkasan
- Audit visibilitas brand di AI mengukur empat hal per prompt dan per mesin: disebut atau tidak, posisi di antara brand yang disebut, sentimen, dan jenis sumber yang dikutip.
- Set 30 prompt dibagi 8 awareness, 10 consideration, 8 decision, dan 4 reputasi, dengan slot [kategori], [brand], dan [kota] agar bisa dipakai ulang untuk industri apa pun.
- Lembar skor usulan WEBARQ Promote memberi bobot 40 untuk disebut, 25 posisi, 15 sentimen, dan 20 sumber. Bobot ini konvensi kami, bukan standar industri.
- Dalam uji 11 November 2026, hasil organik Google untuk kueri yang sama berubah di 4 dari 5 kueri yang diulang dalam hitungan menit. Jalankan setiap prompt minimal tiga kali sebelum menyimpulkan apa pun.
Apa yang sebenarnya diukur audit visibilitas brand di AI?
Audit visibilitas brand di AI adalah pengujian terstruktur yang mencatat seberapa sering dan bagaimana sebuah brand muncul dalam jawaban mesin AI untuk pertanyaan yang diajukan calon pembeli. Ukurannya bukan posisi #1 sampai #10, karena jawaban AI tidak punya daftar peringkat tetap.
Makalah GEO: Generative Engine Optimization (Aggarwal dkk., KDD 2024) menghadapi masalah yang sama dan membuat metrik "impression" sendiri: porsi kata dalam jawaban yang mengutip sebuah sumber, dibobot oleh seberapa awal kalimat itu muncul. Gagasan "posisi dalam jawaban" di lembar skor kami berangkat dari logika itu, tetapi bobotnya bukan dari makalah tersebut.
Untuk kebutuhan CMO dan tim Corporate Communications, empat metrik praktis sudah cukup:
| Metrik | Pertanyaan yang dijawab | Cara mencatat |
|---|---|---|
| Disebut (M) | Apakah brand Anda muncul di jawaban? | 0 atau 1 |
| Posisi (P) | Di urutan ke berapa di antara brand yang disebut? | 1, 2-3, atau 4+ |
| Sentimen (S) | Bagaimana AI menggambarkan brand Anda? | Positif, netral, negatif, plus kutipan kalimatnya |
| Sumber (C) | Dari mana AI mengambil informasinya? | Situs sendiri, media, marketplace/review, forum, atau tidak ada |
Ada yang tidak bisa dibuktikan audit ini. Jawaban AI tidak deterministik, jadi satu putaran hanya sampel, dan audit tidak mengukur klik atau penjualan. Halaman bantuan Ringkasan AI Google sendiri mengingatkan bahwa jawaban AI bisa keliru dan menyarankan pengguna mencoba beberapa versi pertanyaan.
Konteks pasarnya juga perlu realistis. Survei APJII 2026 mencatat 235.261.078 pengguna internet, penetrasi 81,72% (detikInet, 22 Mei 2026), tetapi hanya 18,2% responden yang mengaku mengakses layanan AI (Metro TV News). Karena itu audit sebaiknya selalu menyertakan Google Search di samping ChatGPT, Gemini, dan Perplexity.
Bagaimana membangun set 30 prompt per tahap funnel?
Susun prompt dari pertanyaan yang benar-benar diajukan calon pembeli, lalu bagi menurut tahap funnel: 8 awareness, 10 consideration, 8 decision, dan 4 reputasi. Pakai slot agar set yang sama bisa dipakai ulang untuk kategori lain. Kolom kanan menunjukkan versi yang kami pakai di uji coba kategori software akuntansi online untuk UKM. A2, A4, C8, C10, dan D8 tidak dijalankan, sedangkan D2 dan R1 gagal; rinciannya ada di bagian hasil uji coba.
| ID | Tahap | Template prompt | Contoh di uji coba |
|---|---|---|---|
| A1 | Awareness | Apa itu [kategori]? | apa itu software akuntansi online |
| A2 | Awareness | Apakah bisnis seperti [segmen] perlu [kategori]? | apakah UKM perlu software akuntansi |
| A3 | Awareness | Apa manfaat [kategori] untuk [segmen]? | manfaat software akuntansi untuk UKM |
| A4 | Awareness | Bagaimana cara [tugas utama] untuk [segmen]? | cara membuat laporan keuangan UKM |
| A5 | Awareness | Apa beda [kategori] dan [cara lama]? | perbedaan software akuntansi online dan excel |
| A6 | Awareness | [kategori] untuk [segmen] | software akuntansi online untuk UKM |
| A7 | Awareness | [kategori versi cloud/aplikasi] untuk [skala] | aplikasi akuntansi cloud untuk bisnis kecil |
| A8 | Awareness | Masalah [proses manual] di [segmen] | masalah pembukuan manual UKM |
| C1 | Consideration | [kategori] terbaik untuk [segmen] | software akuntansi online terbaik untuk UKM |
| C2 | Consideration | Rekomendasi [kategori] untuk [segmen] | rekomendasi aplikasi akuntansi untuk UKM |
| C3 | Consideration | [kategori] gratis untuk [segmen] | aplikasi akuntansi gratis untuk UKM |
| C4 | Consideration | Perbandingan [kategori] untuk [segmen] | perbandingan software akuntansi online UKM |
| C5 | Consideration | [kategori] dengan fitur [kebutuhan 1] | software akuntansi dengan fitur pajak dan e-faktur |
| C6 | Consideration | [kategori] terintegrasi [sistem lain] | software akuntansi terintegrasi marketplace |
| C7 | Consideration | [kategori] untuk [model bisnis] di [kota] | aplikasi akuntansi untuk toko online |
| C8 | Consideration | [kategori] yang mudah dipakai pemula | software akuntansi mudah dipakai pemula |
| C9 | Consideration | [kategori] dengan fitur [kebutuhan 2] | software akuntansi dengan stok inventori UKM |
| C10 | Consideration | [kategori] di HP | aplikasi akuntansi di HP untuk UKM |
| D1 | Decision | Harga [kategori] untuk [segmen] di [kota] | harga software akuntansi online untuk UKM |
| D2 | Decision | Paket langganan [kategori] per bulan | paket langganan software akuntansi UKM per bulan |
| D3 | Decision | [kategori] terbaik [tahun] | software akuntansi online terbaik 2026 |
| D4 | Decision | Cara memilih [kategori] untuk [segmen] | cara memilih software akuntansi untuk UKM |
| D5 | Decision | Apakah [kategori] aman? | apakah software akuntansi online aman |
| D6 | Decision | Cara pindah dari [cara lama] ke [kategori] | cara pindah dari excel ke software akuntansi |
| D7 | Decision | [kategori] uji coba gratis | software akuntansi uji coba gratis |
| D8 | Decision | [kategori] online vs desktop untuk [segmen] | software akuntansi online vs desktop untuk UKM |
| R1 | Reputasi | Apa kata orang tentang [brand]? | review software akuntansi online UKM |
| R2 | Reputasi | Apakah [brand] terpercaya? | software akuntansi online terpercaya |
| R3 | Reputasi | Kelebihan dan kekurangan [brand] | kelebihan dan kekurangan software akuntansi online |
| R4 | Reputasi | Keluhan pengguna [brand] | keluhan pengguna software akuntansi UKM |
Awareness: apakah brand Anda ikut mendefinisikan kategori?
Prompt A1 sampai A8 tidak meminta daftar brand, jadi yang dicari di sini adalah sumber: halaman Anda atau milik pihak lain yang dipakai untuk menjelaskan kategori.
Consideration: siapa yang masuk daftar pendek?
Sepuluh prompt consideration paling menentukan skor, karena di sinilah AI menyusun daftar brand dan urutannya. Isi slot [kebutuhan] dengan fitur yang benar-benar membedakan produk Anda, misalnya integrasi e-faktur atau marketplace.
Decision: apakah AI menyampaikan harga dan syarat dengan benar?
Di prompt harga, paket, keamanan, dan migrasi, catat setiap angka atau syarat yang salah beserta sumber yang dikutip. Untuk bank atau multifinance, suku bunga atau syarat pengajuan yang tidak berlaku lagi perlu diteruskan ke tim compliance.
Reputasi: apa kata AI tentang perusahaan Anda?
Empat prompt reputasi paling relevan untuk perusahaan Tbk dan tim Corporate Secretary. Jalankan versi brand-nya. Di uji coba kami memakai versi kategori, karena demo ini tidak mengaudit satu brand tertentu.
Bagaimana menyusun lembar skor visibilitas brand di AI?
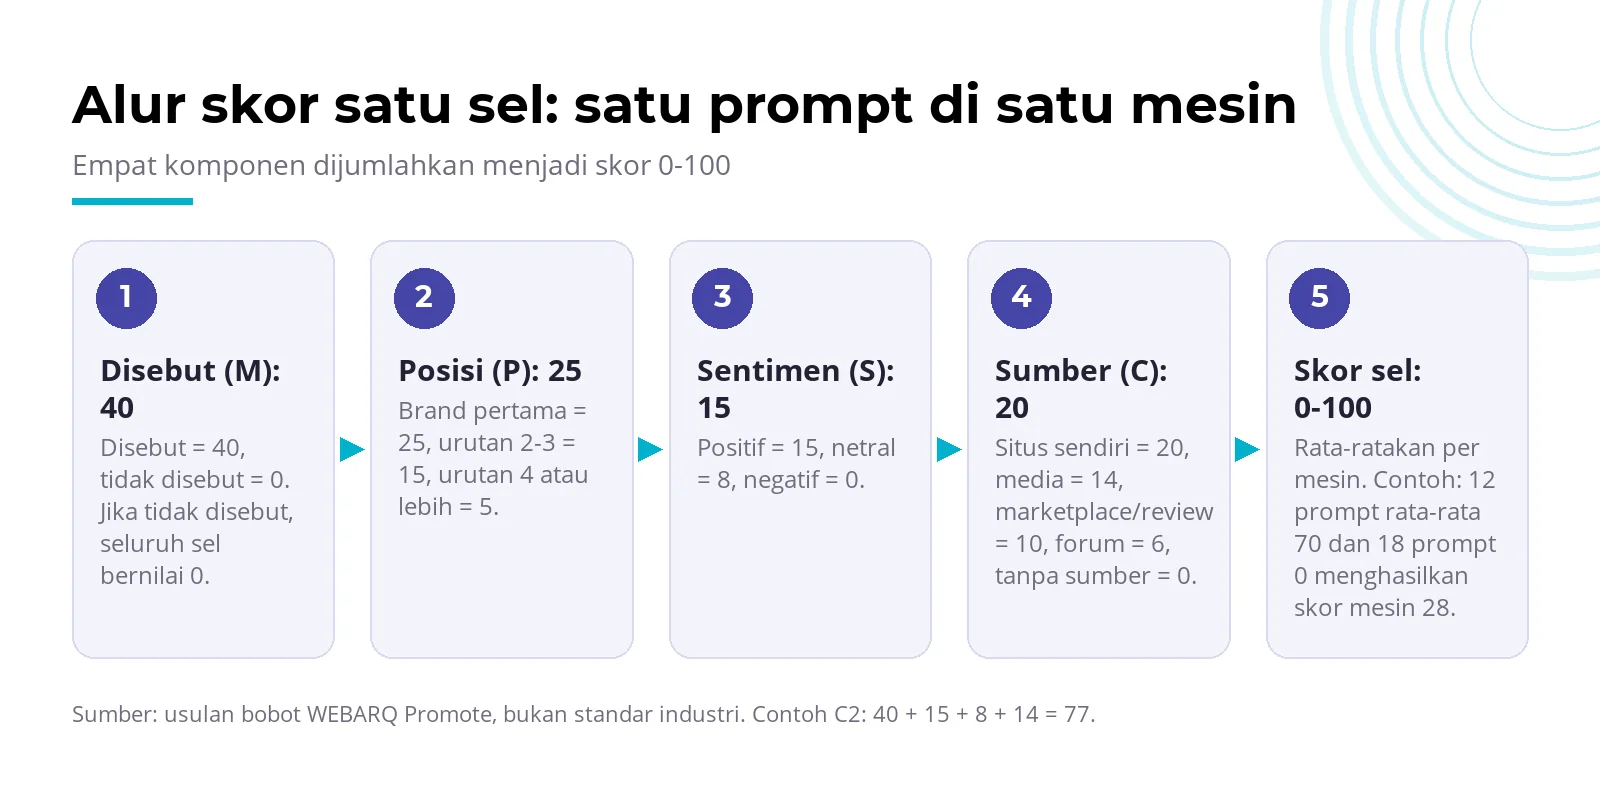
Beri setiap sel (satu prompt di satu mesin) skor 0-100 dari empat komponen, lalu rata-ratakan per mesin. Bobot di bawah ini adalah usulan WEBARQ Promote, bukan standar industri. "Disebut" mendapat bobot terbesar karena tanpa itu komponen lain tidak berarti.
Bila prioritas Anda reputasi, misalnya untuk emiten yang sedang disorot, naikkan bobot sentimen, asalkan konsisten antarputaran.
| Komponen | Bobot maks | Aturan poin |
|---|---|---|
| Disebut (M) | 40 | Disebut = 40, tidak disebut = 0. Jika tidak disebut, seluruh sel bernilai 0 |
| Posisi (P) | 25 | Brand pertama = 25, urutan 2-3 = 15, urutan 4 atau lebih = 5 |
| Sentimen (S) | 15 | Positif = 15, netral = 8, negatif = 0. Simpan kutipan kalimatnya |
| Sumber (C) | 20 | Situs sendiri = 20, media = 14, marketplace/review = 10, forum = 6, tanpa sumber = 0 |
Untuk laporan direksi, tampilkan skor per mesin, bukan hanya rata-rata gabungannya.
Contoh hitung (brand rekaan, bukan hasil audit). Di prompt C2, brand X disebut sebagai brand kedua (40 + 15), dengan nada netral (8), dan informasinya dikutip dari artikel media (14). Skor sel: 77.
Di prompt R4, brand X disebut di urutan keempat (40 + 5) dalam konteks keluhan (0), bersumber dari forum (6). Skor sel: 51. Di prompt C1, brand X tidak disebut: 0.
Misalkan dari 30 prompt di satu mesin, brand X disebut di 12 prompt dengan rata-rata skor sel 70, dan tidak disebut di 18 prompt. Skor mesinnya (12 × 70 + 18 × 0) / 30 = 840 / 30 = 28. Angka 28 itu yang masuk slide direksi, bersama dua catatan: di tahap mana brand hilang, dan sumber apa yang dikutip saat brand muncul.
Untuk menyerap variasi jawaban, jalankan setiap prompt tiga kali dan pakai rata-ratanya sebagai nilai sel. Pekerjaannya tiga kali lipat. Uji coba di bawah menunjukkan alasannya.
Bagaimana menjalankan audit tanpa bias?
Jalankan setiap prompt dalam sesi bersih, dengan kata-kata yang persis sama, tiga kali per mesin, dan catat tanggal, model, serta lokasi. Tanpa kontrol ini, dua anggota tim bisa mendapat skor berbeda untuk brand yang sama.
Alasannya terdokumentasi oleh penyedia mesinnya sendiri, per November 2026:
- ChatGPT. Menurut OpenAI Help Center, ChatGPT menulis ulang pertanyaan menjadi kueri pencarian, dapat memakai perkiraan lokasi dari alamat IP, dan memori tersimpan bisa memengaruhi kueri itu. Pencarian web tersedia juga tanpa login, jadi uji dalam keadaan logout.
- Perplexity. Perplexity Help Center menyebut setiap jawaban menyertakan kutipan bernomor. Pengaturan "Best" memilih model per pertanyaan, jadi catat model yang dipakai.
- Google AI Overview dan AI Mode. Menurut halaman Fitur AI dan situs Anda di Google Search Central, keduanya bisa memakai model dan teknik berbeda, termasuk "query fan-out" (beberapa pencarian terkait sekaligus). AI Overview hanya tampil bila sistem Google menilainya bernilai tambah.
- Gemini. Kami belum memverifikasi dokumentasi resmi tentang cara aplikasi Gemini menampilkan sumber. Catat apa yang tampil di setiap jawaban.
Dua hal praktis lagi. Pertama, pakai prompt berbahasa Indonesia untuk pasar Indonesia, lalu jalankan versi bahasa Inggris hanya jika pembeli Anda memang bertanya dalam bahasa Inggris, misalnya procurement perusahaan multinasional. Kedua, uji dari lokasi yang relevan. Brand properti di Surabaya dan di Jabodetabek bisa mendapat jawaban berbeda untuk prompt yang sama begitu slot [kota] diisi.
Apa hasil uji coba di kategori software akuntansi online untuk UKM?
Kami menjalankan set ini untuk kategori software akuntansi online untuk UKM, kategori netral yang kami pilih sebelum uji. Satu domain yang muncul di hasil organiknya ternyata milik klien WEBARQ Promote, jadi domain itu tidak kami tampilkan di tabel. Temuan utamanya justru soal batas alat ukur: elemen AI Overview terdeteksi di 28 dari 28 balasan yang berhasil, tetapi teks dan sumbernya tidak terbaca di satu pun. Jadi tidak ada penyebutan brand di jawaban AI yang bisa kami amati.
Metode: Analisis WEBARQ Promote, 11 November 2026, 25 kueri unik + 5 ulangan (28 balasan berhasil), DataForSEO SERP (Google, mobile, lokasi Indonesia, bahasa Indonesia) dan data LLM Mentions (platform Google). Dua kueri, D2 dan R1, gagal dua kali dengan galat server 40101 dan tidak dihitung. Lima prompt tidak dijalankan (A2, A4, C8, C10, D8) karena batas 30 panggilan termasuk ulangan. ChatGPT, Gemini, dan Perplexity tidak diuji dalam putaran ini.
Semua 28 elemen itu berupa placeholder yang dimuat belakangan, tanpa teks maupun tautan. Pada uji 30 kueri kami tanggal 22 Oktober 2026, elemen AI Overview terdeteksi di 22 dari 30 kueri dan isinya terbaca di 10. Penyebab perbedaannya belum kami uji. Pelajarannya sederhana: alat yang sama bisa memberi tingkat keterbacaan berbeda dari hari ke hari.
Yang bisa kami baca adalah dua sinyal di sekitarnya: domain di hasil organik Google untuk kueri yang sama, dan kemunculan domain sebagai sumber di jawaban AI Google menurut dataset LLM Mentions.
| Domain | Muncul di hasil organik (dari 23 kueri) | LLM Mentions, Google, Indonesia |
|---|---|---|
| akuntansiku.co.id | 8 | tidak diukur |
| bee.id | 8 | 2.522 |
| ukirama.com | 7 | tidak diukur |
| accurate.id | 5 | 9.582 |
| eranyacloud.com | 5 | tidak diukur |
| kledo.com | 5 | 1.269 |
| mekari.com | 5 | tidak diukur |
| jurnal.id | 4 | 4.999 |
| hashmicro.com | 4 | 1.293 |
Kolom organik menghitung satu kemunculan per kueri di putaran pertama, untuk 23 kueri yang datanya berhasil. Tabel memuat domain dengan kemunculan organik terbanyak, kecuali scribd.com (situs berbagi dokumen) dan domain klien tadi. Sebagian situs ini blog vendor, reseller, atau konsultan.
Kolom LLM Mentions menghitung jawaban AI Google di dataset penyedia yang mengutip domain itu untuk semua topik, bukan hanya software akuntansi. Itu bukan pangsa suara dan bukan traffic. Tabel ini potret satu hari, bukan penilaian atas produk mana pun.
Lalu soal variasi. Kami mengulang lima kueri (C1, C2, D1, D3, R2) beberapa menit setelah panggilan pertama, dan hanya C1 yang memberi daftar domain identik. Hasil teratas sama hanya di 1 dari 5 kueri. Ini volatilitas hasil organik Google, bukan variasi jawaban AI, tetapi pesannya sama: satu putaran adalah bukti yang lemah.
Begini bentuk lembar skor setelah uji coba. Kolom tiga mesin AI sengaja kosong karena memang tidak kami jalankan:
| Prompt | Google AI Overview | Organik Google (2 panggilan) | ChatGPT | Gemini | Perplexity |
|---|---|---|---|---|---|
| C1 | Terdeteksi, isi tidak terbaca | 9 domain, identik dan urutan sama | diuji sendiri | diuji sendiri | diuji sendiri |
| D1 | Terdeteksi, isi tidak terbaca | 8 dan 8 domain, 1 sama | diuji sendiri | diuji sendiri | diuji sendiri |
| R2 | Terdeteksi, isi tidak terbaca | 7 dan 8 domain, 4 sama | diuji sendiri | diuji sendiri | diuji sendiri |
Bagaimana membaca skor, dan apa langkah sesudahnya?
Baca skor rendah sebagai masalah sumber lebih dulu, bukan masalah prompt. Mesin AI menyusun jawaban dari halaman yang bisa ia temukan dan percayai, jadi perbaikannya ada di halaman Anda dan di sumber pihak ketiga yang membicarakan Anda. Pola skor per tahap dan per komponen menunjukkan jenis masalahnya.
| Pola di lembar skor | Kemungkinan penyebab | Langkah berikutnya |
|---|---|---|
| Jarang disebut di semua mesin | Tidak ada halaman yang menjawab prompt kategori, atau halaman tidak terindeks | Buat halaman kategori, perbandingan, dan harga yang menjawab langsung. Cek indeks di Search Console |
| Skor jauh lebih rendah di satu mesin | Akses crawler terblokir untuk mesin itu | Cek robots.txt dan CDN, misalnya OAI-SearchBot untuk ChatGPT |
| Disebut, tetapi di urutan 4+ | Brand jarang masuk daftar dan ulasan pihak ketiga | Perkuat ulasan, liputan media, dan profil di marketplace atau direktori |
| Disebut dengan sentimen negatif atau info salah | Sumber lama atau keluhan yang belum ditanggapi | Dokumentasikan, koreksi di sumbernya, perbarui halaman resmi |
| Disebut, tetapi selalu dari sumber pihak ketiga | Situs sendiri kurang informatif atau sulit dikutip | Tambahkan data, definisi, dan jawaban langsung di halaman resmi |
Dua catatan teknis. Google menyatakan tidak ada file khusus, markup, atau structured data tambahan yang diperlukan untuk tampil di AI Overview atau AI Mode; pernyataan itu hanya berlaku untuk fitur Google. Untuk ChatGPT, OpenAI mensyaratkan situs mengizinkan OAI-SearchBot dan tidak memblokir alamat IP crawler-nya di host atau CDN.
Soal isi, makalah GEO menemukan bahwa menambahkan kutipan sumber, kutipan langsung, atau statistik memberi kenaikan relatif terbesar, hingga sekitar 40% pada skor visibilitas. Itu lingkungan riset dengan mesin berbasis gpt-3.5-turbo, bukan AI Overview atau ChatGPT, jadi perlakukan sebagai arah, bukan janji. Konsepnya kami bahas di artikel tentang generative engine optimization.
Untuk perusahaan Tbk: jangan mencoba "mengakali" jawaban lewat konten tiruan. Bila AI menyampaikan informasi yang salah, koreksi di sumbernya (siaran pers, halaman investor relations, media yang mengutip data lama), lalu audit ulang bulan berikutnya.
Kapan audit manual ini tidak cukup?
Audit manual cukup untuk skor awal dan keputusan "perbaiki dasar dulu atau investasi di GEO". Ia tidak cukup ketika Anda perlu memantau ratusan prompt, beberapa negara, atau tren mingguan. Hitung bebannya: 30 prompt × 4 mesin × 3 putaran = 360 jawaban yang harus dibaca dan diberi skor.
Tool pemantauan membantu di skala itu, tetapi cek dulu cakupannya. Uji coba di atas menunjukkan alasannya: dataset kami tidak punya data ChatGPT untuk Indonesia, dan alat SERP mengembalikan AI Overview tanpa isi. Tanyakan ke vendor platform dan negara mana yang diukur, dan apakah jawaban mentahnya bisa Anda lihat.
Audit juga tidak menggantikan pengukuran dampak. Google menghitung kemunculan situs di fitur AI ke dalam laporan Performance Search Console (jenis penelusuran Web). Gabungkan skor audit dengan laporan Search Console bulanan dan data lead di CRM.
Terakhir, tidak ada audit yang menjamin brand Anda muncul, baik di ChatGPT maupun di Google. Fondasinya tetap SEO yang rapi: halaman terindeks, informasi konsisten, dan sumber yang layak dikutip.
Pertanyaan yang sering diajukan
Apa itu SEO AI?
SEO AI adalah upaya agar brand dan halaman Anda disebut serta dikutip dalam jawaban mesin AI seperti AI Overview, ChatGPT, Gemini, dan Perplexity, bukan hanya meraih peringkat di daftar hasil. Istilah lainnya GEO dan AEO. Dasarnya tetap SEO biasa: menurut Google, fitur AI di Search tidak membutuhkan optimasi khusus di luar praktik SEO yang baik.
Berapa sering perlu mengaudit visibilitas brand di AI?
Kami menyarankan audit penuh 30 prompt setiap kuartal, ditambah pengecekan bulanan untuk sekitar 10 prompt rekomendasi dan reputasi. Dalam uji kami, hasil organik Google saja sudah bergeser dalam hitungan menit, jadi tren dari beberapa putaran lebih bermakna daripada satu angka. Audit ulang juga setelah peluncuran produk, rebranding, atau pemberitaan besar.
Apakah audit visibilitas AI butuh tool berbayar?
Untuk audit pertama, tidak. Set 30 prompt, sesi bersih, dan spreadsheet cukup untuk skor awal. Tool pemantauan berguna saat Anda butuh ratusan prompt, beberapa pasar, atau tren mingguan. Sebelum membeli, cek platform dan negara yang dicakup: dataset yang kami uji hanya punya data platform Google untuk Indonesia.
Mengapa jawaban ChatGPT atau AI Overview berubah-ubah?
Jawaban disusun ulang setiap kali. ChatGPT menulis ulang pertanyaan menjadi kueri pencarian dan bisa memakai lokasi serta memori pengguna. Perplexity bisa memilih model berbeda per pertanyaan, dan menurut Google, AI Overview dan AI Mode bisa memakai model yang berbeda satu sama lain. Dalam uji kami, hasil organik Google pun berubah di empat dari lima kueri yang diulang beberapa menit kemudian.
Apakah audit ini menjamin brand muncul di ChatGPT?
Tidak. Audit mengukur posisi Anda saat ini dan menunjukkan celah yang bisa diperbaiki. OpenAI menyatakan penempatan di hasil pencarian ChatGPT tidak dijamin, dan Google menyebut memenuhi semua syarat teknis pun tidak menjamin halaman tampil. Yang bisa Anda kendalikan adalah kualitas sumber, akses crawler, dan konsistensi informasi brand.
Langkah pertama minggu ini
Isi slot [kategori], [segmen], dan [brand] di tabel 30 prompt, pilih 10 prompt consideration dan reputasi, lalu jalankan masing-masing tiga kali di ChatGPT dalam keadaan logout, Perplexity, Gemini, dan Google. Dari situ Anda sudah punya skor awal per mesin dan daftar sumber yang perlu diperbaiki.
Ingin tahu bagaimana brand Anda muncul di jawaban AI? Tim AI Search Optimization kami bisa memetakan posisinya.